Una richiesta di corsa, su Uber, doveva essere giudicata in una frazione di secondo. Dentro quella frazione c’erano il pagamento, l’account takeover, la collusione tra driver e rider, l’abuso delle promozioni. Nel 2017 il team di fraud prevention raccontò il sistema che reggeva quel giudizio. Si chiama Mastermind, ed è un motore di regole. I modelli ci stanno dentro. Non chiudono la decisione.
Prima del motore
Prima di Mastermind la logica da regole era sparsa nel codice. Un team accettava o rifiutava l’iscrizione di un driver. Un altro governava le corse. Un analista che voleva una regola nuova doveva passare da un engineer, e scrivere e deployare quella regola prendeva circa un’ora. I dettagli si perdevano nel passaggio di mano. [1]
Il team usa il machine learning in lungo e in largo, e nonostante questo ha costruito un rules engine. Nel post le ragioni sono tre. Chi froda è più veloce del training di un modello. In alcuni casi un’euristica è più accurata del dato su cui alleneresti. Gli eventi agganciati al sistema sono una ventina, dal login all’iscrizione alla richiesta di corsa, e un team piccolo non costruisce un modello per ciascuno: i modelli stanno sugli eventi difficili, come la richiesta di corsa, e le regole sul resto. [1]
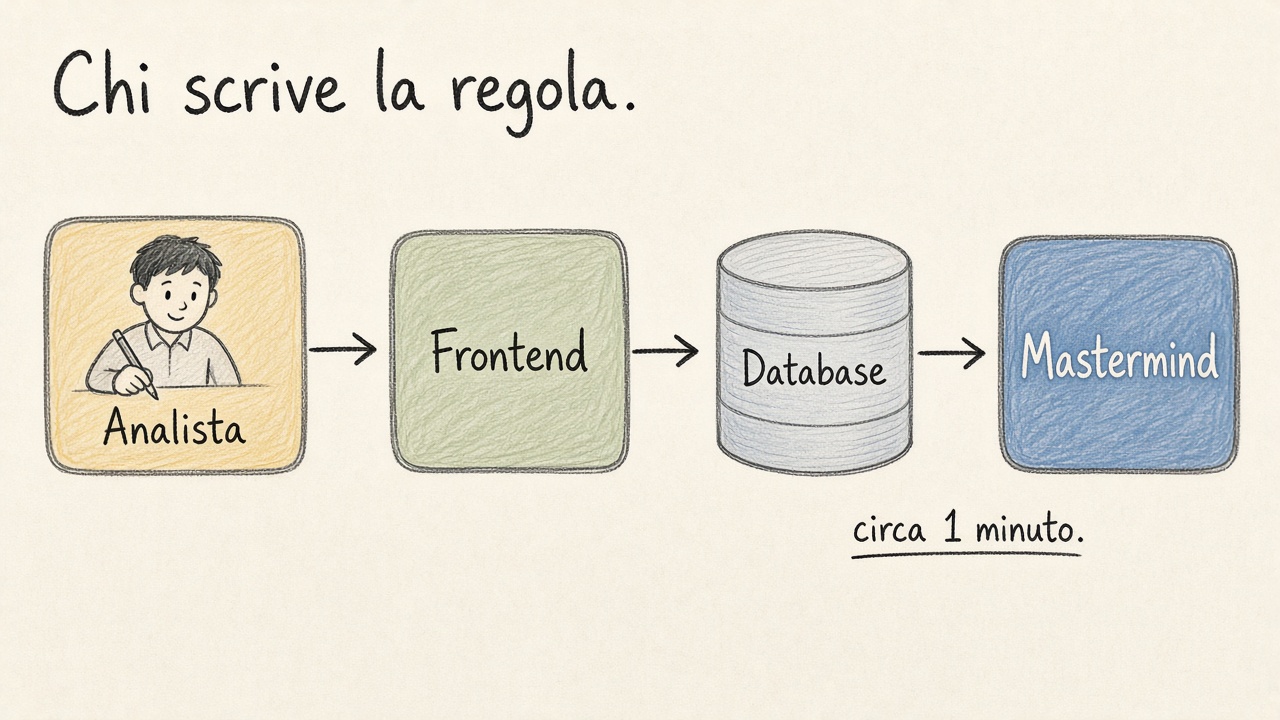
La velocità che gli interessava, all’inizio, non era quella del gradient. Era quella dell’analista. Nella prima versione le regole erano dizionari Python: due mesi per costruirla, più di un anno in produzione, e ancora circa un’ora tra l’idea e il deploy. Nella seconda, l’analista scrive dal frontend, la regola finisce in un database, Mastermind la ricarica in memoria. Il cambiamento è in produzione in circa un minuto. Sulla prima versione, 300 regole richiesero un anno e mezzo. Sulla seconda, 200 regole nuove arrivarono nei tre mesi dopo il lancio del frontend. [1]
Chi parla con chi
Il post disegna due percorsi. Uno è quello di chi scrive la regola. L’altro è quello dell’evento, quando un utente fa qualcosa.
La regola ha tre pezzi. La property dice se, in quella città o in quel paese, è Inactive, Evaluate o Active, e tiene le costanti locali, per esempio una soglia. I predicate sono espressioni: scattano solo se sono tutti veri. Le action sono l’uscita, e se più regole ne producono, Mastermind le aggrega in un solo insieme. I predicate e le action si riusano. La property appartiene a quella regola. I controlli sono organizzati in checkpoint, uno per tipo di evento, e dentro un checkpoint le regole sono indipendenti.
Poi arriva la richiesta vera.
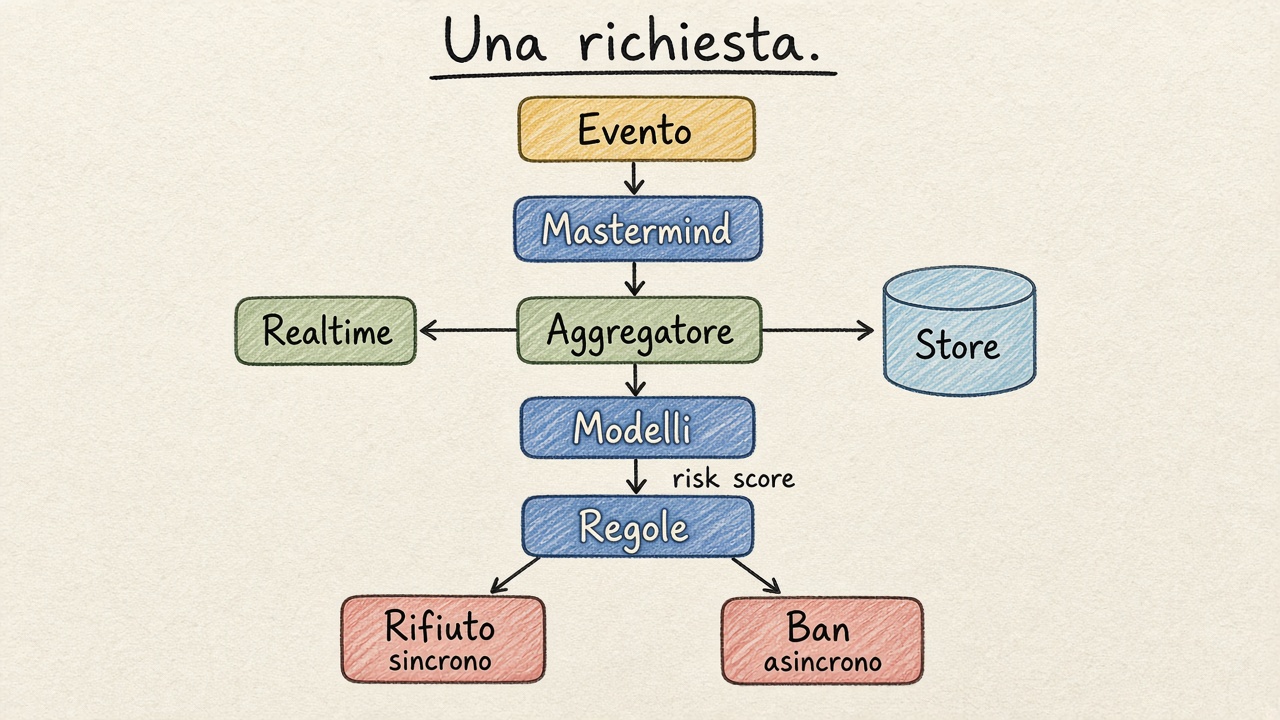
L’esempio che Uber mette nel post, per una feature, è il numero di richieste di corsa nell’ultima ora. Con il vettore pronto, Mastermind chiama il servizio di machine learning. Torna indietro uno o più risk score. Quegli score vengono scritti di nuovo dentro le feature, e solo a quel punto girano le regole. Nella figura, «Regole» è ancora Mastermind: è lo stesso processo, disegnato due volte così si vede dove nasce il numero e dove nasce l’azione. [1]
L’unità che va in produzione è questa cascata. Il modello produce un numero. La regola, che può leggere quel numero insieme al resto, produce un’azione. Un rischio moderato rallenta la velocità delle richieste, per dare al sistema altro tempo. Un rischio alto rifiuta la corsa e può bannare l’utente. Il rifiuto torna subito al chiamante. Il ban passa da un servizio a parte, in asincrono.
Trecento regole complesse, nel post, stanno in 30 millisecondi. Il vincolo è prosaico: Mastermind è in Python, il GIL impedisce di valutare le regole in parallelo sui core, e loro hanno risposto tenendo in memoria gli alberi sintattici già parsati. [1]
C’è un dettaglio che vale quanto l’architettura. In Python l’espressione None < 1 è vera. Una regola scritta come «se la feature è minore di 1, banna» banerebbe chiunque abbia quella feature mancante. Predicate-eval, il linguaggio che hanno costruito sopra l’AST di Python, quella valutazione non la permette. Il confronto insicuro non è implementato, quindi non si può esprimere. Hanno fatto la stessa cosa con eval(): non lo usano, parsano l’espressione e accettano solo i nodi in whitelist, così dal frontend non si raggiunge la classe base. [1]
Dove nascono i numeri
Uber descrive come una regola entra, e dice poco su come si misura dopo. Quello che c’è, va letto con precisione.
Una regola nuova nasce in Evaluate. Gira sul traffico, scrive log, non tocca l’utente. L’analista guarda quanto spesso scatta e, nelle loro parole, come si comporta in generale. Poi la passa ad Active.
Quando hanno sostituito la prima versione con la seconda, il controllo era un altro. Hanno mandato il traffico di produzione attraverso entrambi i motori. Il nuovo registrava la decisione che avrebbe preso, senza eseguirla. Hanno confrontato le due uscite. Quando coincidevano, hanno spento il primo. È un test di parità tra due motori, non una misura di precision. [1]
Il post si chiude sul problema che questo meccanismo non risolve. La maggior parte delle regole resta efficace per qualche settimana. Poi chi froda si adatta, e la regola raccoglie più falsi positivi. La cosa che chiedono, e che nel 2017 non avevano, è una valutazione automatica dell’efficacia nel tempo, più una coda di review umana quando la confidenza nella regola non basta. [1]
La misura, in un altro sistema
Mastermind, nel 2017, si ferma a quella richiesta. Il contatore, regola per regola, lo pubblica Stripe, e lo pubblica in una guida per chi usa Radar, non in un design doc del motore.
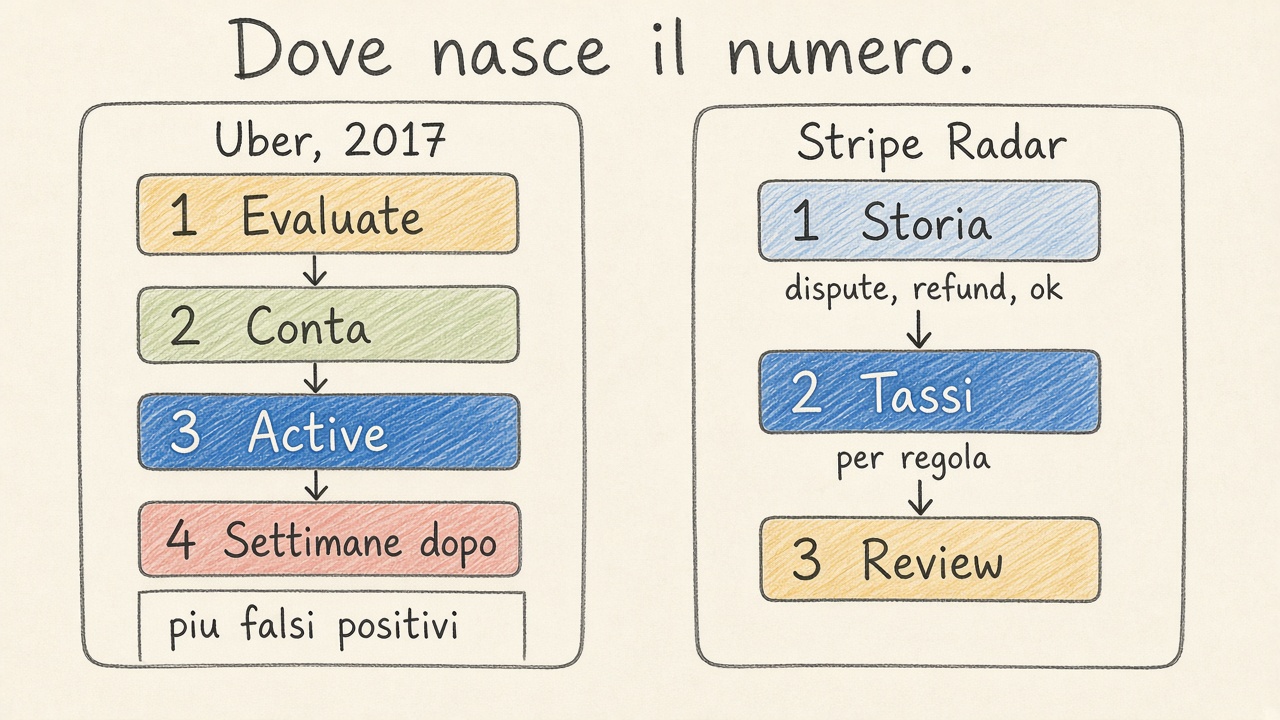
Nella guida di Radar una regola è trattata come un modello semplice, un albero decisionale corto, e va giudicata sullo stesso scambio tra precision e recall. Prima di attivarla, il prodotto mostra sulla storia quanti pagamenti corrispondenti sono finiti in dispute, in refund o accettati. Da viva, si legge il tasso di falsi positivi e il tasso di dispute di quella regola. [2]
La review manuale è il terzo gesto. Mandare una classe di pagamenti a un umano invece di bloccarla alza la precision senza cedere recall. Mandarcela invece di lasciarla passare alza la recall senza cedere precision. Il costo è il tempo del revisore. [2]
Abnormal, sul rilevamento degli attacchi email, tiene la stessa forma e cambia gli attori. Un messaggio viene letto da modelli diversi: il comportamento di chi scrive e di chi riceve, il contenuto, l’identità, i link. Gli score di questi pezzi, insieme a embedding del messaggio, entrano in un classificatore che stima la probabilità di attacco. Un modello monolitico grande resta, come un segnale tra gli altri. [3]
Quello che il post del 2017 lascia in mano
Mastermind risponde a un vincolo di calendario. L’analista deve poter mettere una condizione in produzione in un minuto, perché chi froda non aspetta un ciclo di training, e perché una ventina di eventi non può avere ciascuno il suo modello. Il modello resta nel percorso: gira, restituisce uno score, e quello score diventa una feature che la regola può leggere. L’azione la firma la regola.
Il post è onesto sul rovescio. Una regola veloce da pubblicare è anche veloce a invecchiare, e loro, nel 2017, non avevano ancora il contatore che lo dice in automatico. La guida di Stripe è il posto in cui quel contatore diventa un prodotto: disputed, refunded, accepted prima del via, e da lì in avanti il tasso di errore di quella singola regola.
La prossima lettera sta sul gradino di mezzo del disegno, quello in cui l’aggregatore va a prendere «quante richieste nell’ultima ora». È lì che il sistema si accorge di un attacco nuovo senza aspettare che qualcuno riscriva la regola.
Fonti
[1] Yifu Diao, Isabel Geracioti, «Mastermind: Using Uber Engineering to Combat Fraud in Real Time», Uber Engineering, 8 marzo 2017. Post di engineering. Ci ho preso il flusso della richiesta, le tre ragioni del rules engine, Evaluate e lo shadow tra le due versioni, i tempi, e la chiusura sulle regole che invecchiano. Non pubblica la formula con cui una regola viene dichiarata efficace.
[2] Stripe, «A primer on machine learning for fraud protection», guida di Radar, pagina aggiornata al 15 dicembre 2021. Guida per chi usa il prodotto, non un design doc. Ci ho preso solo il modo in cui una regola viene misurata prima e dopo l’attivazione, e il ruolo della review umana. L’economia del break-even resta per un’altra lettera.
[3] Abnormal Security, «Combining ML models to detect email attacks», engineering blog. Contrasto breve: stessi ruoli di Mastermind, attori diversi. Ci ho preso la scomposizione in sotto-modelli e il fatto che i loro score entrano nel classificatore finale.