La scomposizione in Componenti Principali (PCA) è spesso introdotta nei corsi universitari come un semplice calcolo di autovalori sulla matrice di covarianza. Nella realtà ingegneristica e nei sistemi di produzione delle Big Tech, questo approccio didattico fallisce per motivi di stabilità numerica e scalabilità computazionale.
In questa prima parte della nostra serie, smonteremo i fondamenti algebrici della PCA, analizzando perché la Singular Value Decomposition (SVD) sia la scelta d’elezione a livello industriale e come i problemi di ottimizzazione vincolata modellino lo spazio latente dei dati.
1. Perché la PCA usa la SVD? (Oltre la didattica lineare)
Definizione Formale della Matrice di Covarianza
Sia $X \in \mathbb{R}^{n \times d}$ una matrice di dati centrata (con media per colonna pari a zero), dove $n$ rappresenta il numero di campioni e $d$ il numero di feature. La matrice di covarianza $\Sigma \in \mathbb{R}^{d \times d}$ è definita formalmente come:
$$\Sigma = \frac{1}{n} X^T X$$
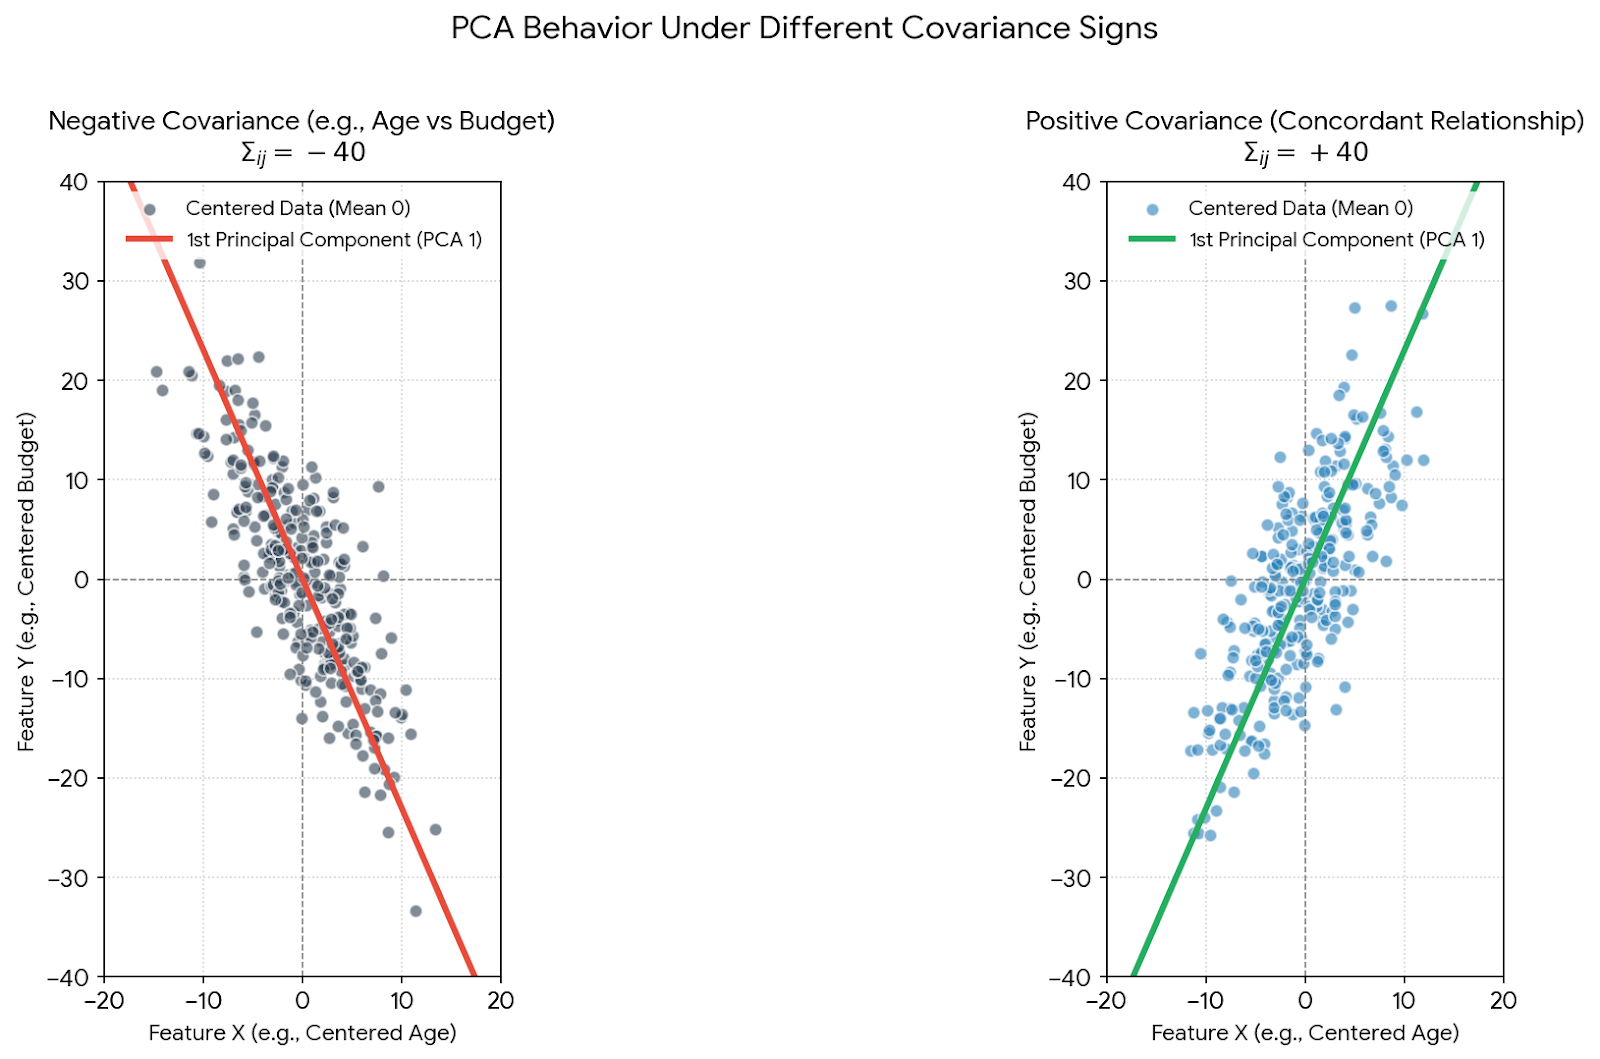
Ogni elemento $\Sigma_{ij}$ rappresenta la covarianza tra la feature $i$ e la feature $j$. Geometricamente, descrive il comportamento congiunto delle variabili: se $\Sigma_{ij} > 0$, al crescere della feature $i$ corrisponde una tendenza all’aumento della feature $j$.
Esempio pratico: Età vs Budget
Immagina un dataset di e-commerce con due sole feature ($d=2$): Età dell’utente e Budget speso. Calcolando $\Sigma$, otteniamo una matrice $2 \times 2$:
- Sulla diagonale principale troviamo le varianze dei singoli comportamenti ($\sigma^2_{\text{età}} = 25$, $\sigma^2_{\text{budget}} = 100$).
- Il valore $-15$ fuori diagonale indica una covarianza negativa: all’aumentare dell’età, il budget speso tende a diminuire. La PCA sfrutta esattamente queste relazioni per ruotare gli assi cartesiani originari verso la retta di massima varianza.
2. Il Problema della Stabilità Numerica: Condition Number
In analisi numerica, la stabilità di un sistema algoritmico viene misurata tramite la condition number (numero di condizionamento) di una matrice quadrata $A$, indicata con $\kappa(A)$:
$$\kappa(A) = \Vert{}A\Vert{} \cdot \Vert{}A^{-1}\Vert{} = \frac{\sigma_{\max}(A)}{\sigma_{\min}(A)}$$
Questo indice definisce quanto l’output di un algoritmo sia sensibile alle piccole perturbazioni o agli errori di arrotondamento in virgola mobile (a 32 o 64 bit).
- Se $\kappa(A)$ è vicino a 1, la matrice è ben condizionata.
- Se $\kappa(A) \gg 1$, la matrice è mal condizionata e i calcoli numerici divergono.
Nei software di produzione (come scikit-learn), non si calcola quasi mai la matrice di covarianza esplicita $\Sigma = \frac{1}{n}X^T X$, preferendo l’applicazione della SVD (Singular Value Decomposition) direttamente sulla matrice dei dati centrati $X$. I motivi sono tre:
- Incolumità della precisione di macchina: Calcolare il prodotto $X^T X$ raddoppia l’esponente della condition number: $\kappa(X^T X) = \kappa(X)^2$. Se la tua matrice di input $X$ ha un condizionamento moderato di $10^4$, il passaggio a $X^T X$ lo proietta a $10^8$, distruggendo metà dei bit di precisione disponibili per l’arrotondamento computazionale. La SVD aggira completamente il prodotto, lavorando direttamente su $X$.
- Asimmetria delle dimensioni ($n \ll d$ o $d \ll n$): In presenza di dataset fortemente sbilanciati (es. analisi genomica o classificazione di immagini con $10.000$ feature e solo $100$ campioni), calcolare $\Sigma$ significherebbe allocare una matrice quadrata enorme da $10.000 \times 10.000$. La Truncated SVD estrae le prime $k$ componenti senza mai generare l’intero spazio intermedio.
- Ottimizzazione nativa per matrici sparse: Nei contesti di Text Mining, elaborazione di grafi o elaborazione di dati tabulari su larga scala, la SVD permette l’uso di solutori iterativi che evitano la saturazione della memoria.
3. Applicazioni Industriali in Big Tech: Matrici Sparse
Nel software su scala globale, i dati reali non si presentano quasi mai in forme dense. Due esempi verticali chiarificano la necessità di architetture sparse:
- Sistemi di Raccomandazione (es. Netflix, Amazon): Strutturati su matrici Utenti-Prodotti in cui le righe ($100\text{M}$) incrociano le colonne ($100\text{K}$). Poiché un utente medio interagisce con una frazione infinitesima del catalogo, oltre il $99.9%$ della matrice è composto da zeri (dati mancanti).
- Fraud Detection (Sistemi di pagamento): Matrici di interazione Utente-Dispositivo o grafi di transazione. I pattern fraudolenti rappresentano anomalie isolate all’interno di una marea di transazioni standard e ripetitive.
Se provassimo a calcolare la covarianza tramite $\frac{1}{n}X^T X$, il prodotto interno tra vettori densificherebbe istantaneamente la matrice, portando al crash per Out-Of-Memory (OOM). Nelle infrastrutture Big Tech si implementano soluzioni algebriche alternative:
# Esempio concettuale di Truncated SVD per matrici sparse con Scikit-Learn
from scipy.sparse import csr_matrix
from sklearn.decomposition import TruncatedSVD

# Matrice sparsa fittizia (es. 100M utenti x 100K prodotti)
sparse_data = csr_matrix([[1, 0, 0, 2], [0, 0, 3, 0], [5, 0, 0, 0]], dtype=float)

# Estrazione diretta delle componenti principali senza calcolo della covarianza
svd = TruncatedSVD(n_components=2, algorithm='randomized')
latent_features = svd.fit_transform(sparse_data)- Algoritmo di Lanczos / Randomized SVD: Metodi iterativi che calcolano le prime $k$ componenti attraverso iterazioni basate solo sul prodotto matrice-vettore ($X \cdot v$). Poiché l’algoritmo salta nativamente gli elementi nulli, la complessità computazionale scala linearmente rispetto al numero di elementi non zero ($O(\text{nnz})$).
- Alternating Least Squares (ALS): Utilizzato nel Collaborative Filtering, adatta la scomposizione SVD isolando i soli elementi definiti ed escludendo i dati mancanti (anziché trattarli come zeri assoluti), fattorizzando la matrice in embedding a basso rango per utenti e item.
4. Fondamenti della PCA: Massima Varianza e Ottimizzazione Vincolata
Che significa “Centrare la Matrice”?
La formulazione matematica della PCA richiede tassativamente che la matrice sia centrata:
$$X_{\text{centrato}} = X - \mu$$
Se omettessimo questa operazione, il primo vettore della PCA non indicherebbe l’asse lungo cui i dati si disperdono maggiormente, ma punterebbe direttamente dall’origine geometrica $(0,0)$ verso il baricentro della nuvola dei dati. Centrare la matrice sposta l’origine degli assi nel baricentro del cluster, isolando la variabilità pura dalle distanze assolute.
Il Vincolo Unitario
Vogliamo proiettare la matrice centrata $X \in \mathbb{R}^{n \times d}$ su una retta definita da un vettore direzionale $w \in \mathbb{R}^d$. Per isolare la pura componente geometrica della direzione, dobbiamo imporre che il vettore sia unitario:
$$|w| = 1 \iff w^T w = 1$$
Senza questo vincolo, il problema di ottimizzazione divergerebbe: basterebbe scalare la lunghezza di $w$ all’infinito per decretare un aumento fittizio della varianza proiettata, senza aver modificato l’orientamento dello spazio.
La varianza delle proiezioni dei punti $x_i$ su $w$ viene espressa come:
$$\text{Var}(Xw) = \frac{1}{n} \sum_{i=1}^n (x_i^T w)^2 = \frac{1}{n} (Xw)^T (Xw) = w^T \left( \frac{X^T X}{n} \right) w = w^T \Sigma w$$
Formalizzazione con i Moltiplicatori di Lagrange
Per massimizzare la varianza sotto il vincolo di ortogonalità del vettore, ricorriamo alla funzione Lagrangiana $\mathcal{L}$:
$$\mathcal{L}(w, \lambda) = w^T \Sigma w - \lambda (w^T w - 1)$$
Calcolando il gradiente rispetto a $w$ e ponendolo pari a zero per identificare i punti stazionari:
$$\nabla_w \mathcal{L} = 2\Sigma w - 2\lambda w = 0$$
$$\Sigma w = \lambda w$$
L’ottimizzazione vincolata ci riconduce all’equazione degli autovalori. La direzione $w$ che massimizza la varianza dei dati proiettati corrisponde all’autovettore della matrice di covarianza $\Sigma$ associato all’autovalore massimo $\lambda$.
5. Il Dualismo Lineare: Il Teorema di Eckart-Young
Il risultato ottenuto tramite i moltiplicatori di Lagrange non è isolato, ma rappresenta la soluzione duale del Teorema di Eckart-Young-Mirsky. La PCA può infatti essere definita secondo due filosofie speculari:
| Prospettiva | Obiettivo Matematico | Tecnica Algebrica |
|---|---|---|
| Massima Varianza | Massimizzare la dispersione dei dati proiettati nel sottospazio latente. | Moltiplicatori di Lagrange applicati a $\Sigma$. |
| Minimo Errore di Ricostruzione | Minimizzare la distanza geometrica tra i dati originali e la loro proiezione a rango ridotto. | Distanza di Frobenius su matrice di rango $k$. |
Il Teorema di Eckart-Young formalizza la seconda via, dimostrando che la miglior approssimazione a rango ridotto $k$ di una matrice $X$ viene ottenuta troncando la scomposizione SVD ($X = U\Sigma V^T$) alle prime $k$ componenti:
L’identità tra i due approcci è assoluta: i vettori singolari destri $V$ ricavati minimizzando l’errore di ricostruzione tramite SVD sono i medesimi autovettori ricavati massimizzando la funzione Lagrangiana della varianza.
Massimizzare la varianza preservata equivale a minimizzare l’errore di informazione scartata. Questa conclusione costituisce il ponte teorico ideale verso il Deep Learning: la stessa identica funzione di costo basata sull’errore di ricostruzione sarà l’elemento fondante per lo sviluppo degli Autoencoder, che tratteremo dettagliatamente nella seconda parte di questa serie.
6. Verso un Sistema E2E di Fraud Detection: La Roadmap Industriale
Nel mondo reale, e in particolare nei sistemi di Fraud Detection (Antifrode) su scala Big Tech, la PCA non è mai il punto di arrivo: è il motore di compressione iniziale all’interno di una pipeline complessa End-to-End (E2E).
I dati transazionali sono per loro natura enormi, sparsi e affetti dalla maledizione della dimensionalità. Ridurre le feature preservando l’informazione pura è solo il primo passo per alimentare i modelli predittivi successivi, ottimizzando le risorse computazionali e azzerando la ridondanza.
Il Punto d’Inizio: La Regressione Logistica (Parte 2)
Una volta estratte le componenti principali stabili e liberate dalla multicollinearità, il passo ingegneristico standard è dare in pasto queste feature proiettate a un classificatore per stimare la probabilità che una transazione sia una frode ($P(Y=1|X)$).
Nella Parte 2 di questa serie, analizzeremo nel dettaglio la Regressione Logistica. Nei sistemi di produzione reali, la Regressione Logistica rappresenta il punto di inizio (baseline) insostituibile. È un modello snello, interpretabile, in grado di girare in tempo reale sotto la soglia critica dei 10 millisecondi per bloccare i pagamenti sospetti prima che vadano a buon fine. Nel prossimo articolo vedremo come gestire l’estremo sbilanciamento delle classi (dove le frodi rappresentano spesso meno dello 0.1% del totale) e come ottimizzare la cross-entropy per calibrare le probabilità di rischio senza generare falsi positivi catastrofici per il business.
L’Oltre Non-Lineare: Gli Autoencoder (Parte 5)
Cosa succede, però, se i pattern delle frodi sono troppo sofisticati ed un apporccio non basta più? È qui che si crea il perfetto ponte teorico con la Parte 5 di questa serie, dedicata agli Autoencoder.
Un Autoencoder è una rete neurale progettata per replicare lo scopo della PCA: comprimere i dati in un collo di bottiglia latente (bottleneck) per poi ricostruirli minimizzando l’errore. Tuttavia, grazie all’introduzione delle funzioni di attivazione non lineari, gli Autoencoder superano i limiti della geometria ortogonale, permettendoci di mappare relazioni ultra-complesse e intercettare anomalie che la PCA classica finirebbe inevitabilmente per scartare come rumore.
▼
SVD Stabile / PCA
▼ │
▼
▼ Prossimo Passo · Parte 2
Regressione Logistica
(Baseline E2E)
• Stima delle probabilità di frode
• Latenza < 10ms in produzione
▼ Evoluzione Avanzata · Parte 5
Autoencoder Deep Learning
• Anomalie non lineari ad alta dimensionalità
• Rappresentazioni latenti complesse
Nel prossimo capitolo…
Se la PCA ci ha permesso di ridefinire la geometria dello spazio e stabilizzare il calcolo numerico, ora dobbiamo trasformare queste coordinate latenti in decisioni di business binarie: Transazione Sicura o Frode?
Il viaggio nel Machine Learning di produzione richiede una baseline solida prima di scalare verso il Deep Learning. Nella Parte 2, metteremo da parte le matrici di covarianza per sporcarci le mani con le funzioni sigmoidee, l’ottimizzazione del gradiente, la regolarizzazione contro l’overfitting e le metriche di calibrazione delle probabilità.
Continua alla Parte 2 →