La Baseline Inossidabile: Anatomia della Regressione Logistica nel Machine Learning Bancario
Nel capitolo precedente abbiamo visto come domare il caos dei Big Data. Attraverso la PCA e il motore numerico della SVD, abbiamo ripulito il nostro dataset bancario, eliminando la trappola della multicollinearità e riducendo centinaia di feature correlate in poche Componenti Principali pulite e ortogonali.
Ora che i nostri dati hanno una struttura geometrica impeccabile, siamo pronti per il passo successivo: costruire un modello predittivo.
Nel mondo del Machine Learning, la complessità affascina, ma la semplicità governa la produzione. Prima di schierare algoritmi a scatola chiusa come le reti neurali, ogni Data Scientist deve rispondere a una domanda fondamentale: “Qual è la nostra baseline?”. La Regressione Logistica è lo standard aureo per rispondere a questo quesito. In un contesto altamente regolamentato come quello finanziario, dove ogni decisione deve essere spiegabile alle autorità di vigilanza, questo algoritmo non è solo un punto di partenza, ma spesso il pilastro dell’intera infrastruttura di Risk Management.
1. L’Infrastruttura Universale: I 3 Pilastri del Machine Learning
Prima di immergerci nella matematica specifica dell’algoritmo, è fondamentale fare un passo indietro. Ogni modello predittivo iterativo — che si parli di una semplice Regressione Lineare, di una Regressione Logistica o di sistemi complessi come XGBoost — poggia esattamente sulla stessa identica baseline architetturale:
[ 1. Il Predittore ] ---> Produce ŷ (Previsione)
|
v
[ 2. La Loss Function ] -> Calcola l'Errore (J) rispetto a y
|
v
[ 3. L'Ottimizzatore ] --> Calcola i Gradienti e aggiorna i Pesi (W)
Abbracciare questo schema mentale permette di decodificare qualsiasi modello sul mercato analizzandone i tre componenti fondamentali:
- Pilastro 1: Il Predittore (L’Infrastruttura). È la funzione logica che riceve i dati di input ($X$) e i parametri correnti del modello ($W$ o $\beta$, i pesi) per generare una previsione ($\hat{y}$). Nella Regressione Lineare è un iperpiano continuo ($\hat{y} = WX + b$) da $-\infty$ a $+\infty$; nella Regressione Logistica è lo stesso iperpiano compresso da una Sigmoide. Vedremo che per l’ XGBoost si tratta invece di una somma pesata di centinaia di alberi decisionali ($\hat{y} = \sum f(X)$).
- Pilastro 2: La Loss Function (Il Giudice). È la metrica matematica che quantifica lo scarto tra la previsione ($\hat{y}$) e la realtà ($y$). L’addestramento ha l’unico scopo di spingere questo valore il più vicino possibile allo zero.
- Pilastro 3: L’Ottimizzatore (Il Timoniere). Il motore algoritmico che, preso il verdetto della Loss, calcola i gradienti (le derivate parziali) per capire in che direzione e di quanto modificare i pesi del modello nel ciclo successivo.
Capito il framework universale, vediamo come la Regressione Logistica declina questi tre pilastri per dare la caccia alle frodi.
2. Il Predittore: La Funzione Sigmoide
La Regressione Logistica non prevede direttamente una classe, ma calcola una scommessa precisa: la probabilità esatta ($p$) che una transazione appartenga alla classe positiva (la frode).
Per fare questo, prende l’output dell’equazione lineare e lo passa attraverso un imbuto matematico chiamato Funzione Sigmoide (o funzione logistica):
$$\sigma(z) = \frac{1}{1 + e^{-z}}$$
Dove $z$ è la combinazione lineare delle nostre feature (le componenti ottenute dalla PCA): $z = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \dots$.
Qualunque sia il valore di $z$ (da meno infinito a più infinito), la Sigmoide lo schiaccerà rigorosamente in un intervallo compreso tra 0 e 1. Abbiamo ottenuto una probabilità pura.
3. Il Cuore Matematico: Odds Ratios e Log-Odds
Per capire davvero come la Regressione Logistica impara dai dati, dobbiamo abbandonare temporaneamente il concetto di probabilità e passare a quello di Odds (il concetto di “quota” scommessa, tanto caro ai bookmaker).
Se la probabilità di una frode è $p$, la probabilità che la transazione sia legittima è $1-p$. Gli Odds sono semplicemente il rapporto tra queste due forze:
$$\text{Odds} = \frac{p}{1 - p}$$
Se applichiamo il logaritmo naturale agli Odds, otteniamo il Log-Odds (chiamato anche funzione Logit):
$$\ln\left(\frac{p}{1 - p}\right) = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \dots$$
L’Intuito di StatQuest
Perché i matematici fanno questo triplo salto mortale? Perché la relazione tra le feature ($X$) e la probabilità ($p$) non è una linea retta, ma una curva a S (la Sigmoide). Diventa difficilissimo calcolare i coefficienti su una curva. Ma la relazione tra le feature ($X$) e il Log-Odds è perfettamente lineare!
Trasformando il problema in Log-Odds, permettiamo all’algoritmo di usare la matematica dei vettori lineari per trovare la retta (o l’iperpiano) ottimale.
4. L’Ingegneria dell’Apprendimento: Maximum Likelihood Estimation (MLE)
In una regressione lineare, troviamo la retta migliore minimizzando la somma dei quadrati degli errori (Ordinary Least Squares - MSE) secondo la formula:
$$J(w) = \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2$$
Nella Regressione Logistica questo approccio fallisce matematicamente. Se inserissimo il predittore logistico $\hat{y}_i = \sigma(z_i)$ all’interno della loss quadratica MSE, la forte non-linearità della sigmoide distorcerebbe la funzione di costo. Calcolando la sua matrice Hessiana (le derivate seconde rispetto ai pesi), scopriremmo che non è definita semipositiva per ogni configurazione.
Graficamente, la superficie d’errore perderebbe la sua forma a parabola, trasformandosi in una mappa caotica ricca di dossi, falsi piani e minimi locali. Un ottimizzatore basato sulla discesa del gradiente rimarrebbe intrappolato in una buca casuale, non riuscendo mai a convergere verso la configurazione ottimale per isolare i comportamenti fraudolenti.
La Genesi della Binary Cross-Entropy
Per ritrovare la convessità perduta, cambiamo paradigma passando alla Stima della Massima Verosimiglianza (Maximum Likelihood Estimation - MLE). Invece di cercare la retta “più vicina” ai punti, la MLE cerca i coefficienti che rendono i dati reali osservati i più probabili possibili.
Nel nostro sistema antifrode, l’output reale $y_i$ è una variabile bernoulliana: può assumere solo valore $0$ (legittima) o $1$ (frode). Definiamo la probabilità che il modello assegna all’evento frode come $P(y_i=1 \mid x_i) = \hat{y}_i$. Possiamo sintetizzare le due condizioni in un’unica funzione di massa di probabilità (PMF):
$$P(y_i \mid x_i) = \hat{y}_i^{y_i} (1 - \hat{y}_i)^{1 - y_i}$$
Assumendo che tutte le transazioni nel dataset siano indipendenti e identicamente distribuite (i.i.d.), la Verosimiglianza dell’intero sistema è il prodotto delle singole probabilità:
$$L(w) = \prod_{i=1}^{n} \hat{y}_i^{y_i} (1 - \hat{y}_i)^{1 - y_i}$$
Vogliamo massimizzare $L(w)$. Per evitare l’onere computazionale di derivare una produttoria, applichiamo il logaritmo naturale per trasformare i prodotti in somme, ottenendo la Log-Likelihood:
$$\ln L(w) = \sum_{i=1}^{n} \left[ y_i \ln(\hat{y}_i) + (1 - y_i) \ln(1 - \hat{y}_i) \right]$$
Poiché gli ottimizzatori numerici sono configurati per minimizzare le funzioni, invertiamo il segno e normalizziamo per il numero di campioni $n$. Abbiamo appena dedotto la Binary Cross-Entropy Loss (o Log Loss):
$$J(\beta) = -\frac{1}{n} \sum_{i=1}^{n} \left[ y_i \ln(\hat{y}_i) + (1 - y_i) \ln(1 - \hat{y}_i) \right]$$
Grazie alle proprietà combinate di logaritmo e sigmoide, questa formula restituisce una funzione perfettamente convessa: una ciotola impeccabile priva di minimi locali, dove la discesa verso l’ottimo globale è garantita.
5. La Discesa nel Minimo: Il Calcolo del Gradiente
Una volta definito il giudice (la Loss), il timoniere (l’Ottimizzatore) deve aggiornare i parametri. Il ciclo di addestramento si muove su quattro atti precisi:
- Forward Pass (Predizione): Il modello elabora la transazione $X$, applica i pesi correnti $W$ e sputa fuori la probabilità di frode $\hat{y}$ attraverso la sigmoide.
- Compute Loss (Valutazione): La Binary Cross-Entropy calcola la penalità d’errore confrontando la stima con lo stato reale $y$. Se la transazione è una frode ($y_i = 1$), la seconda parte si annulla, e pagheremo una sanzione logaritmica tanto più alta quanto più la nostra scommessa è vicina a zero.
- Backward Pass (Direzione): L’ottimizzatore calcola la derivata parziale della Loss rispetto a ogni singolo peso ($\frac{\partial J}{\partial W}$) per comprendere l’impatto di una variazione infinitesimale dei coefficienti.
- Weight Update (Aggiornamento): I pesi vengono corretti nella direzione opposta al gradiente: $W_{\text{nuovo}} = W_{\text{vecchio}} - (\text{Learning Rate} \times \text{Gradiente})$. Il ciclo si ripete per migliaia di epoche finché la Loss non tocca il fondo.
La Dimostrazione Matematica via Chain Rule
Per calcolare esplicitamente il gradiente di un singolo campione isoliamo l’errore $E = y \ln(\hat{y}) + (1-y)\ln(1-\hat{y})$ e applichiamo la regola della catena (Chain Rule):
$$\frac{\partial E}{\partial w_j} = \frac{\partial E}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial z} \cdot \frac{\partial z}{\partial w_j}$$
Scomponiamo i tre fattori:
- Pezzo A (Dalla Loss alla Predizione): $$\frac{\partial E}{\partial \hat{y}} = \frac{y}{\hat{y}} - \frac{1-y}{1-\hat{y}} = \frac{y(1-\hat{y}) - \hat{y}(1-y)}{\hat{y}(1-\hat{y})} = \frac{y - \hat{y}}{\hat{y}(1-\hat{y})}$$
- Pezzo B (Dalla Predizione alla combinazione lineare): Sfruttando le proprietà derivate della Sigmoide $\hat{y} = \sigma(z)$: $$\frac{\partial \hat{y}}{\partial z} = \hat{y}(1 - \hat{y})$$
- Pezzo C (Dalla combinazione lineare al peso): Essendo $z = w^Tx + b$, la derivata rispetto alla componente $w_j$ è la feature stessa: $$\frac{\partial z}{\partial w_j} = x_j$$
Moltiplicando i tre pezzi secondo la Chain Rule assistiamo a una spettacolare semplificazione algebrica:
$$\frac{\partial E}{\partial w_j} = \left[ \frac{y - \hat{y}}{\hat{y}(1-\hat{y})} \right] \cdot \left[ \hat{y}(1 - \hat{y}) \right] \cdot x_j = (y - \hat{y})x_j$$
Reintroducendo il segno meno della loss e la normalizzazione sull’intero dataset, il gradiente finale rispetto al vettore dei pesi $w$ si condensa in una formula di straordinaria pulizia:
$$\nabla_w J(w) = \frac{1}{n} \sum_{i=1}^{n} (\hat{y}_i - y_i) x_i$$
Le Deduzioni Chiave per il Risk Management
Questa formula rivela due dettagli strutturali cruciali:
- Omogeneità formale: Sorprendentemente, la struttura del gradiente della Regressione Logistica è formata dalle stesse componenti di quella della Regressione Lineare. Tutta l’architettura non-lineare si risolve in un calcolo lineare dell’errore residuo $(\hat{y}_i - y_i)$ scalato per l’input $x_i$.
- Sensibilità ai falsi negativi: Se il sistema commette un errore drammatico — assegnando una probabilità di frode vicina a zero ($\hat{y}_i = 0$) a un crimine reale ($y_i = 1$) — lo scarto residuo esplode a $-1$. Questo valore massimo amplifica istantaneamente il gradiente, imponendo al timoniere una correzione drastica e immediata dei pesi per blindare il sistema al ciclo successivo.
6. Lo Scudo contro il Caos: Gestione della Curse of Dimensionality
Nel capitolo precedente abbiamo usato la PCA per ridurre le dimensioni del problema. Ma cosa succede se decidiamo di mantenere un numero elevato di Componenti Principali, o se il nostro modello si trova a elaborare uno spazio con troppe feature rispetto alle transazioni storiche disponibili?
Entriamo nel terreno della Maledizione della Dimensionalità (Curse of Dimensionality). In spazi geometrici a troppe dimensioni, i dati diventano incredibilmente sparsi. Gli angoli dello spazio iperdimensionale si svuotano e i punti campionari si allontanano drammaticamente tra loro. In questo scenario, la Regressione Logistica — essendo un modello lineare — soffre intrinsecamente il rischio di overfitting: invece di tracciare un iperpiano che generalizza il concetto di “frode”, inizia a memorizzare il rumore specifico dei dati di addestramento.
Per proteggere la nostra baseline da questa trappola, non ci affidiamo solo alla riduzione preventiva (PCA) o alla selezione manuale delle feature (Feature Selection). Introduciamo uno scudo matematico direttamente nel motore del modello: la Regolarizzazione.
7. Matematica della Regolarizzazione: Modificare il Giudice
Perché la regolarizzazione abbia effetto, la penale non può essere un elemento correttivo applicato a posteriori. Deve essere integrata nella funzione di Loss prima di calcolare i gradienti. Dobbiamo letteralmente cambiare le regole del Giudice.
Se al Giudice (la Binary Cross-Entropy) chiediamo solo di minimizzare l’errore, il modello farà di tutto per azzerarlo, gonfiando i coefficienti $\beta$ a dismisura per intercettare anche l’ultimo, insignificante outlier. Nei problemi iperdimensionali (come la classificazione di frodi o anomalie) il vero segnale è spesso concentrato in un piccolo sottoinsieme di feature, mentre il resto dello spazio è saturo di rumore irrilevante. Senza un freno, il modello allineerà i propri pesi a quel rumore.
Introducendo la regolarizzazione, diciamo al Giudice:
“Minimizza l’errore sulle transazioni, ma punisci il modello se la struttura dei suoi pesi diventa troppo complessa”.
In letteratura tale concetto viene formalizzato aggiungendo un temrine di penalità $\mathcal{R}(w)$ alla nostra Loss:
$$J(w) = \text{Loss BCE}(w) + \lambda \mathcal{R}(w)$$
Esistono due modi diversi di infliggere questa penalità (vincolo geometrico): L1 (Lasso) e L2 (Ridge).
Il Caso L2 (Ridge Regression)
Nella regolarizzazione L2, il vincolo è sferico. La funzione di costo totale $J(w)$ diventa la somma della Loss originale e del quadrato della norma euclidea dei pesi:
$$J(w) = \text{Loss BCE}(w) + \frac{\lambda}{2n} \sum_{j=1}^{d} w_j^2$$
Quando l’ottimizzatore calcola la derivata parziale rispetto a ciascun peso $w_j$, la penale quadratica restituisce una componente lineare:
$$\frac{\partial J}{\partial w_j} = \frac{\partial (\text{Loss BCE})}{\partial w_j} + \frac{\lambda}{n} w_j$$
Applicando la regola di aggiornamento della discesa del gradiente con un learning rate $\alpha$, separiamo l’impatto della penale da quello dell’errore reale:
$$w_j := w_j \left( 1 - \alpha \frac{\lambda}{n} \right) - \alpha \frac{\partial (\text{Loss BCE})}{\partial w_j}$$
A ogni singolo passo, prima ancora che il modello guardi l’errore commesso sul dataset, il peso $w_j$ viene moltiplicato per un fattore leggermente inferiore a 1. È il fenomeno del Weight Decay (decadimento dei pesi). I coefficienti vengono rimpiccioliti in modo fluido, ma come vedremo, non toccheranno mai lo zero assoluto.
Il Caso L1 (Lasso Regression)
Nella regolarizzazione L1 (Least Absolute Shrinkage and Selection Operator), la musica cambia radicalmente. La penalità non si basa sui quadrati, ma sulla norma Manhattan, ovvero sulla somma dei valori assoluti dei pesi:
$$J(w) = \text{Loss BCE}(w) + \frac{\lambda}{n} \sum_{j=1}^{d} |w_j|$$
Quando andiamo a calcolare il gradiente di questa funzione, ci scontriamo con una singolarità matematica: il valore assoluto $|w_j|$ non è derivabile nello zero. Tuttavia, per tutti gli altri punti, la sua derivata è costante ed è rappresentata dalla funzione segno ($\text{sgn}(w_j)$), che restituisce $+1$ se il peso è positivo e $-1$ se è negativo:
$$\frac{\partial J}{\partial w_j} = \frac{\partial (\text{Loss BCE})}{\partial w_j} + \frac{\lambda}{n} \cdot \text{sgn}(w_j)$$
L’aggiornamento dei pesi diventa quindi:
$$w_j := w_j - \alpha \frac{\partial (\text{Loss BCE})}{\partial w_j} - \alpha \frac{\lambda}{n} \cdot \text{sgn}(w_j)$$
L’intuizione geometrica
Perché questa formulazione ha proprietà così speciali? Immaginiamo lo spazio dei parametri. La L2 impone un vincolo circolare ($w_1^2 + w_2^2 \le t$), mentre la L1 impone un vincolo a forma di diamante ($|w_1| + |w_2| \le t$), i cui spigoli si trovano esattamente sugli assi cartesiani (dove una delle due feature ha peso pari a zero).
Quando le curve di livello della nostra Loss originaria (BCE) si espandono alla ricerca del punto di minimo, la probabilità matematica che incontrino il diamante della L1 esattamente su uno dei suoi spigoli acuminati è altissima. Al contrario, sul cerchio levigato della L2, l’incontro avverrà quasi certamente in una zona tangenziale in cui entrambi i pesi mantengono un valore, seppur piccolo.
Di conseguenza, la L1 non si limita a rimpicciolire i coefficienti: compie una Feature Selection intrinseca ed esplicita, troncando a zero le variabili che Aggarwal definirebbe “rumore iperdimensionale”.
8. Il Duello: Regolarizzazione L1 vs L2
Sia la L1 che la L2 contrastano la Curse of Dimensionality, ma lo fanno con una filosofia e un’aggressività radicalmente differenti. La differenza risiede nella natura geometrica della penalità.
| Caratteristica | Regolarizzazione L2 (Ridge) | Regolarizzazione L1 (Lasso) |
|---|---|---|
| Penalità sulla Loss | Somma dei quadrati dei pesi ($\sum w_j^2$) | Somma dei valori assoluti dei pesi ($\sum |w_j|$) |
| Derivata della penale | Proporzionale al valore del peso ($\frac{\lambda}{n} w_j$) | Costante, legata solo al segno ($\frac{\lambda}{n} \cdot \text{sgn}(w_j)$) |
| Comportamento | Rimpicciolisce i pesi in modo fluido, senza azzerarli | Spinge i pesi minori esattamente a zero |
| Effetto finale | Controllo della magnitudo (Modello denso) | Feature Selection intrinseca (Modello sparso) |
L’Impatto Geometrico sullo Spazio dei Parametri
Per capire perché questi due approcci producano risultati così diversi, dobbiamo visualizzare la geometria dei loro vincoli nello spazio bidimensionale dei pesi ($w_1, w_2$).
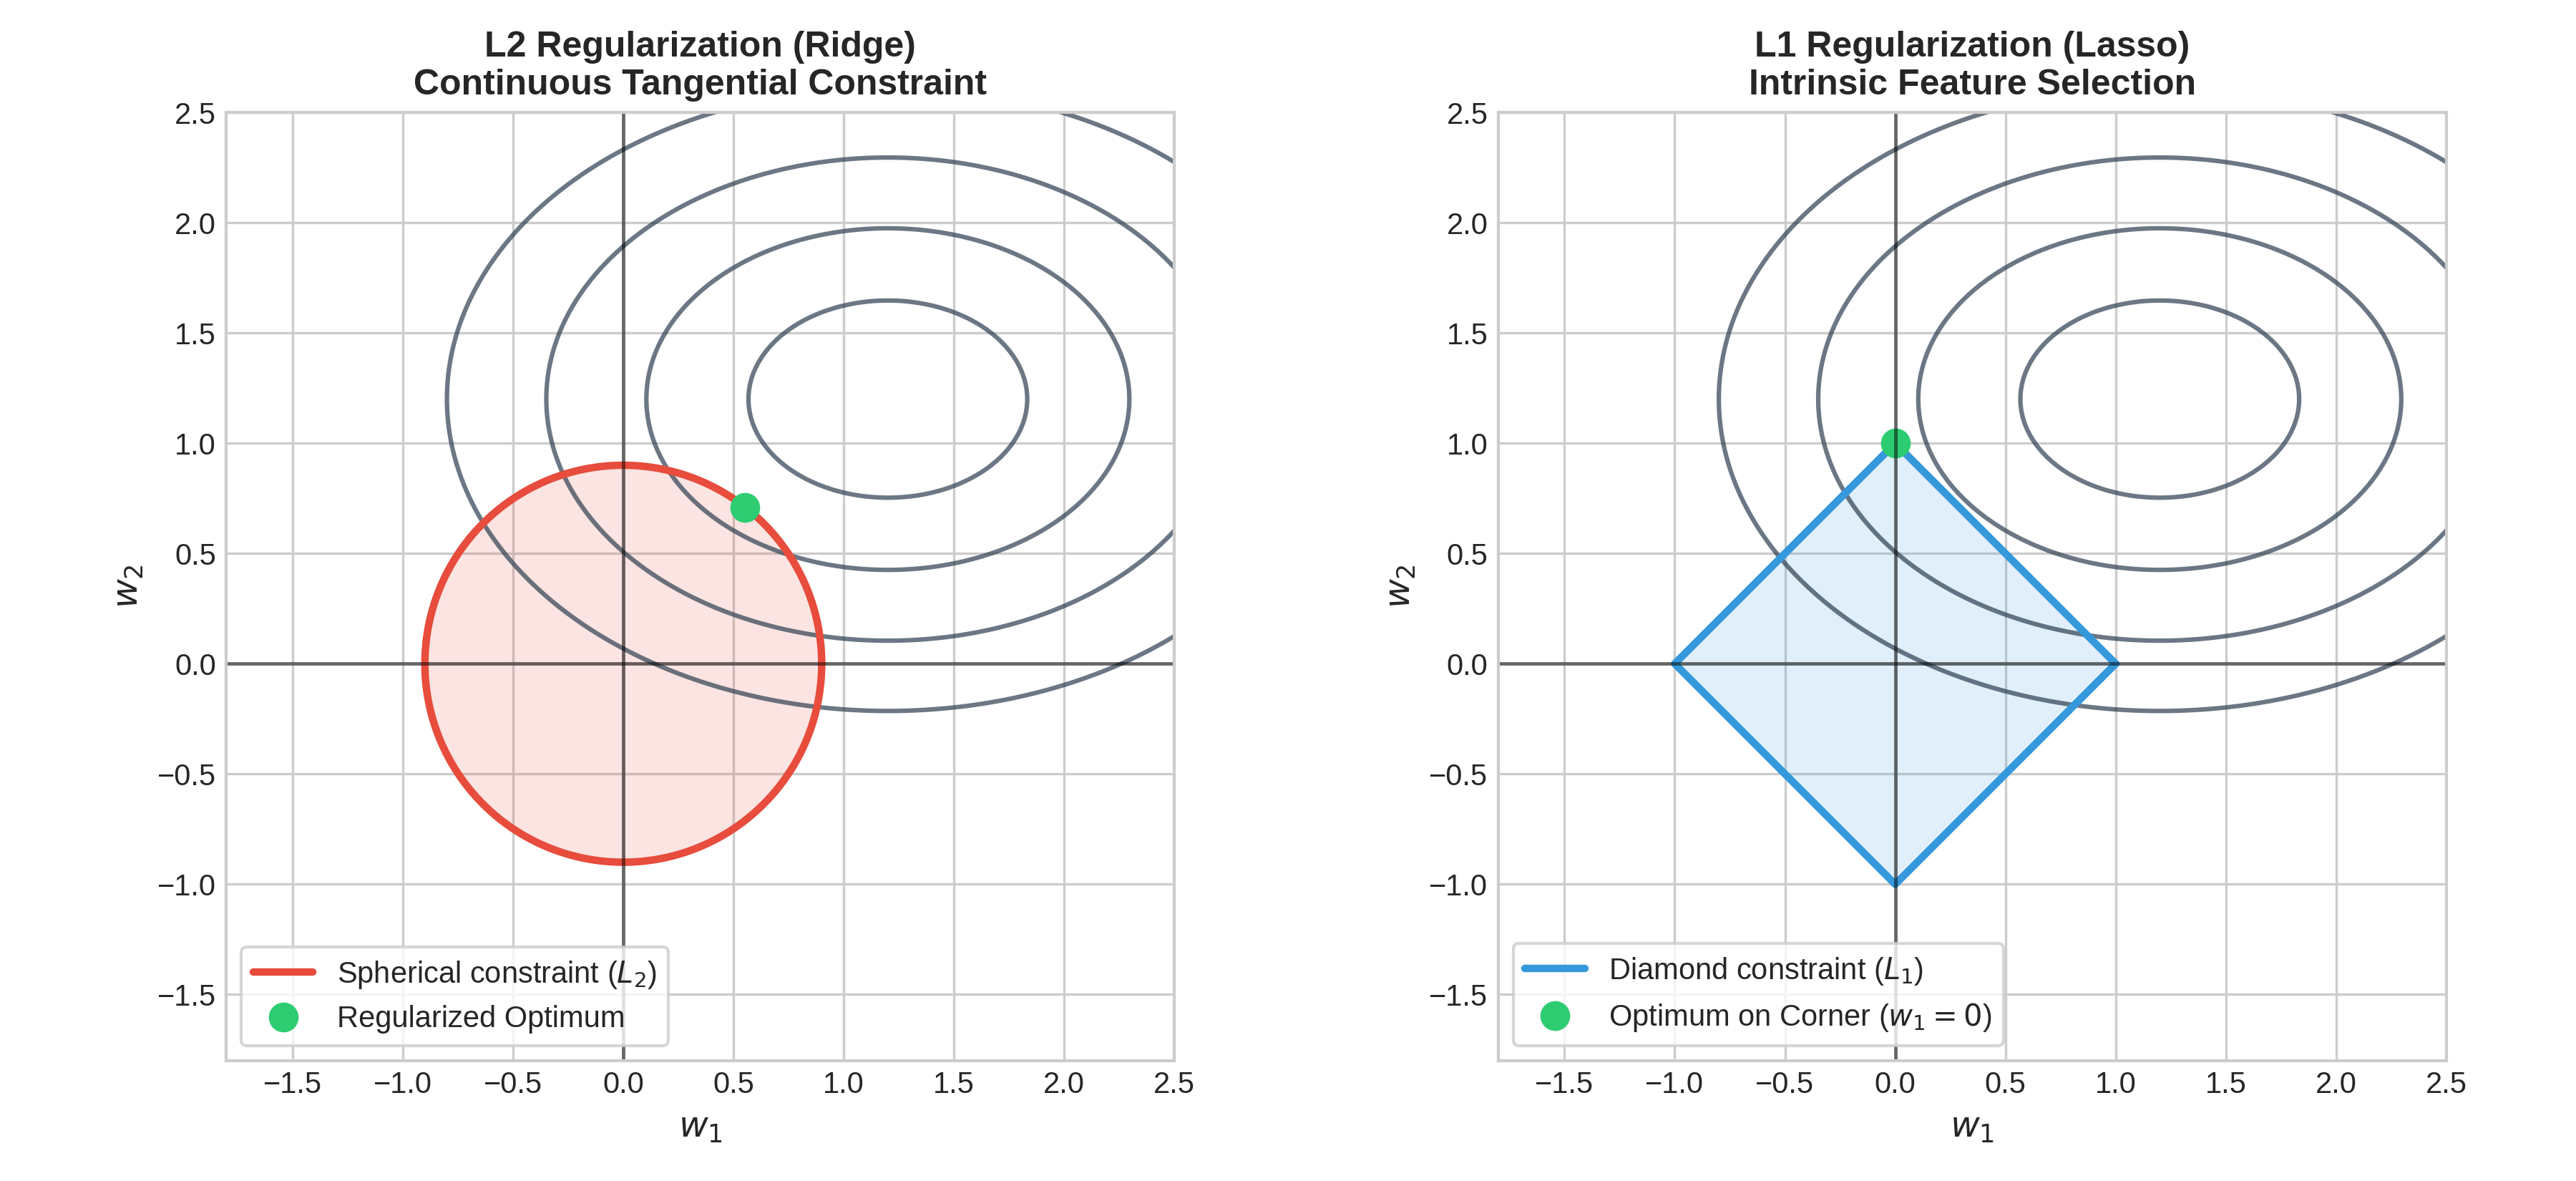
Come mostrato nel grafico, la L2 impone un vincolo circolare levigato, rendendo l’incontro con le curve della Loss puramente tangenziale: i pesi si riducono ma mantengono quasi sempre un valore reale. La L1, invece, genera un vincolo a diamante con spigoli vivi sugli assi cartesiani. La matematica probabilistica descritta in The Elements of Statistical Learning dimostra che le curve di livello della Loss intersecano quasi sempre il diamante proprio su uno di questi spigoli, costringendo una o più feature ad assumere un valore esattamente pari a zero.
Perché la L1 è più aggressiva e spietata della L2?
L’aggressività della L1 risiede interamente nella natura della sua derivata. Possiamo visualizzare questa forza come una vera e propria “pressione verso lo zero” esercitata sui pesi del modello ad ogni singolo passo di ottimizzazione.
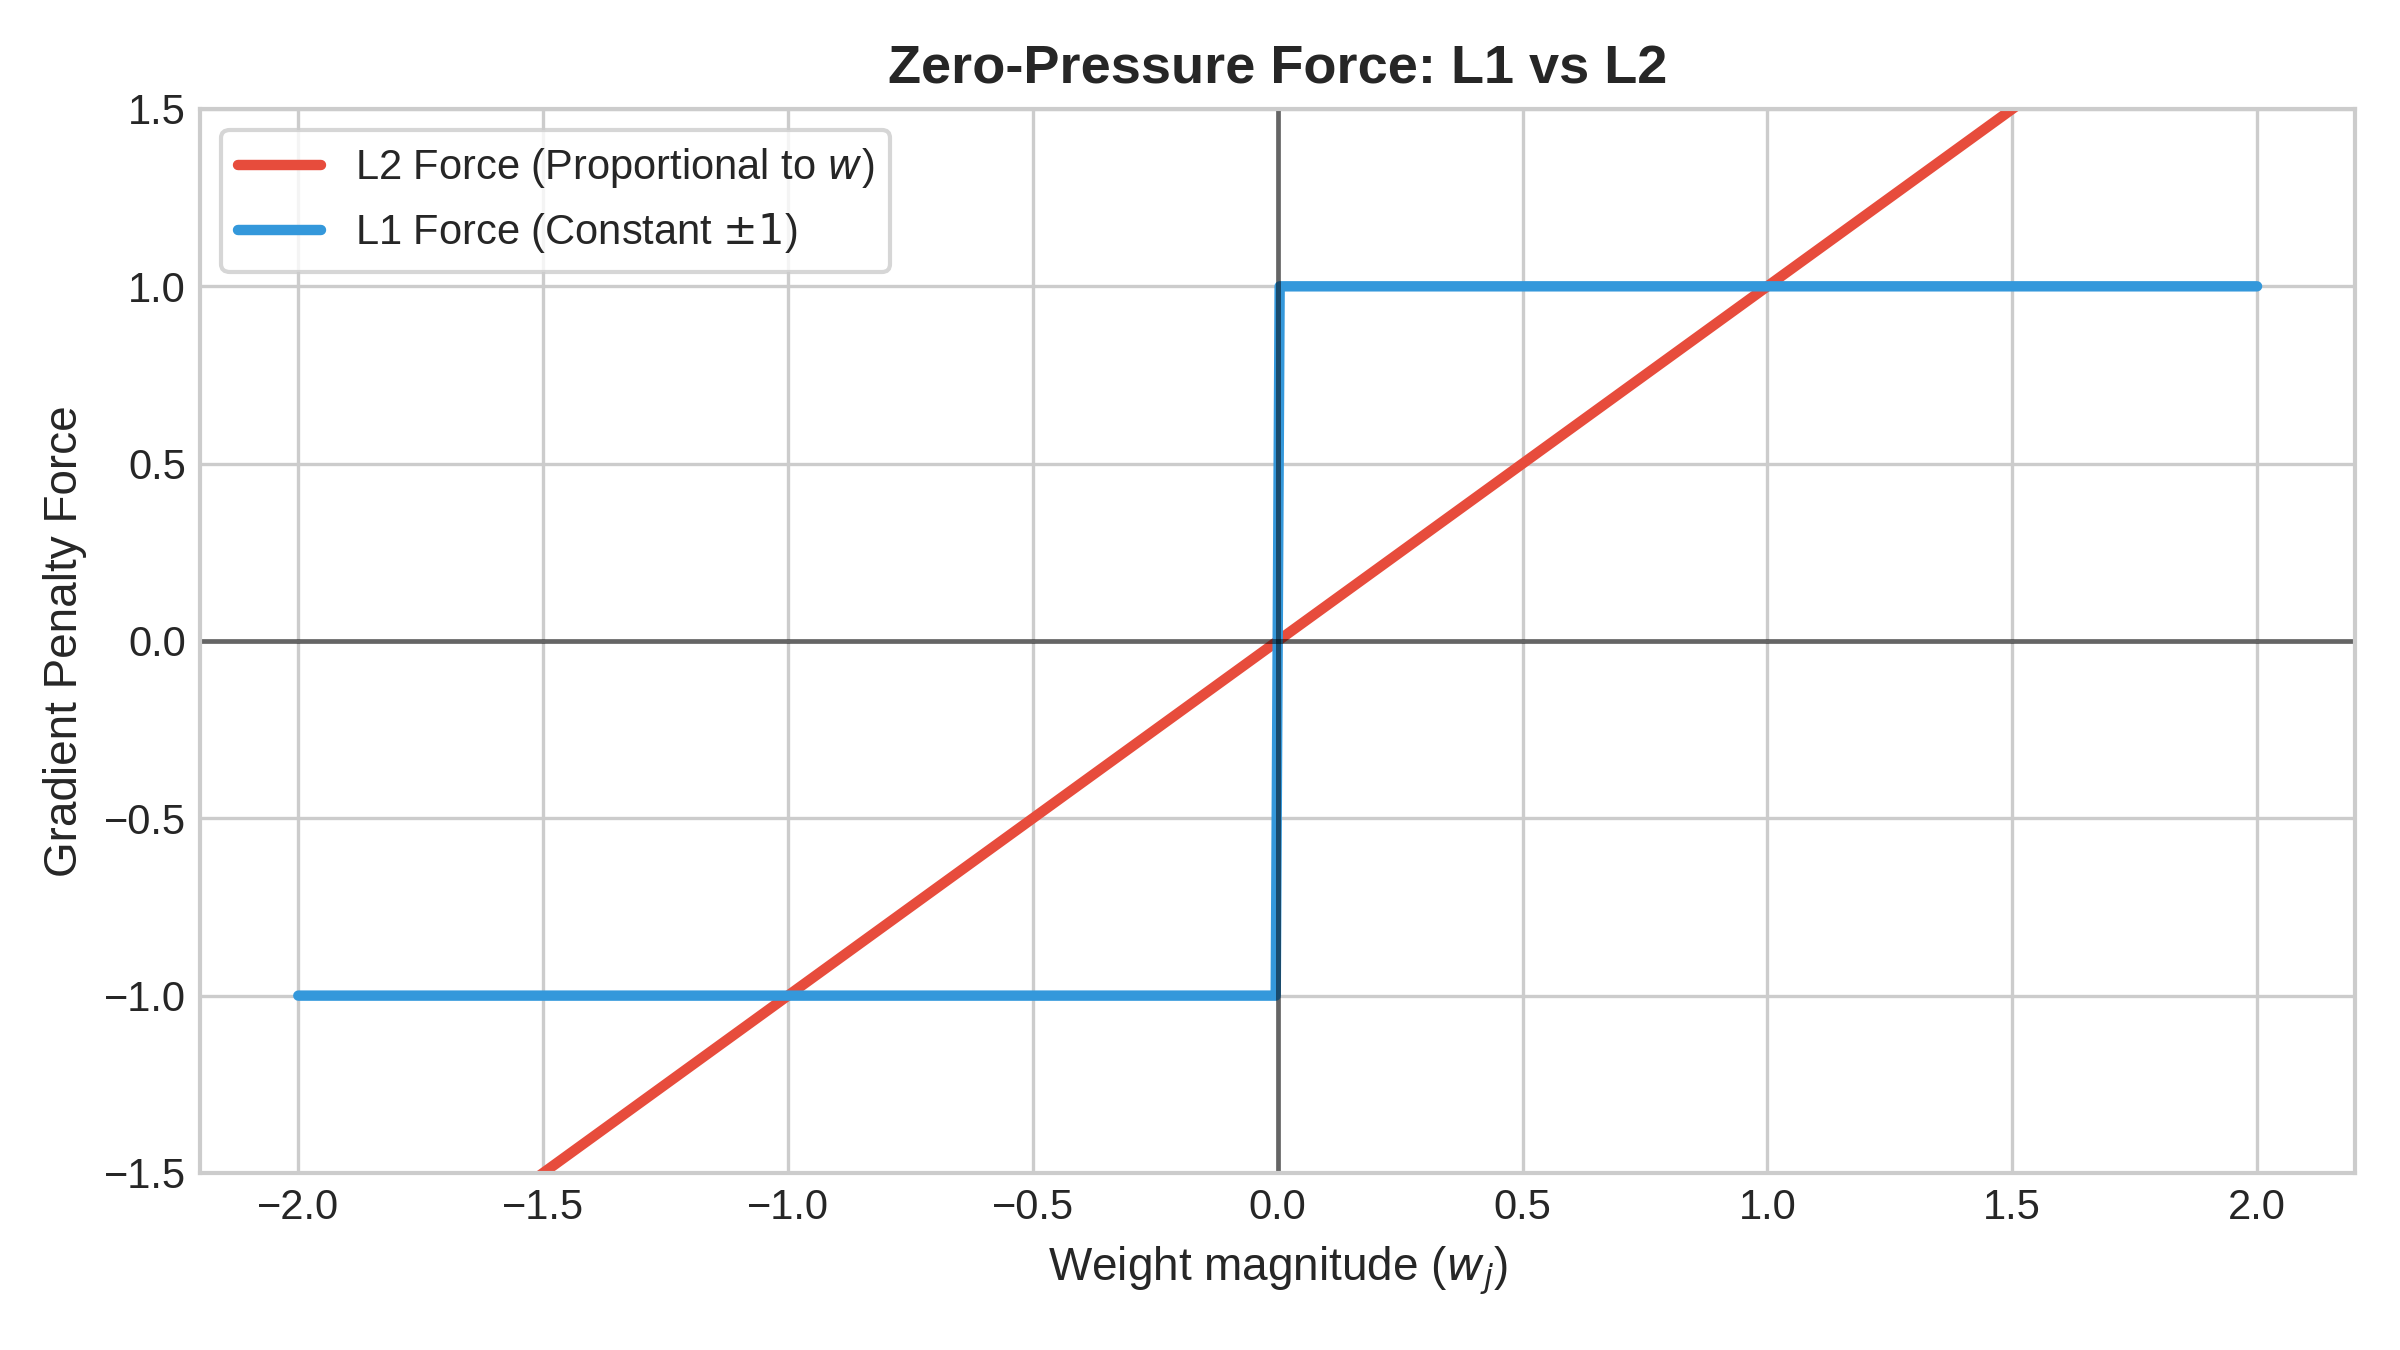
Nella L2, la penalità sul gradiente è proporzionale al valore del peso stesso ($w_j$). Significa che se un peso diventa molto piccolo (es. $0.001$), anche la forza che lo spinge verso il basso diventa infinitesimale. La L2 perde potenza man mano che si avvicina all’origine; rimpicciolisce i coefficienti ma non ha l’energia matematica per azzerarli. I pesi non muoiono mai, diventano solo microscopici.
La regolarizzazione L1 (Lasso), al contrario, non fa sconti. La derivata del valore assoluto $|w_j|$ restituisce unicamente il segno del peso ($\pm 1$), agendo come una costante indipendente dalla grandezza del coefficiente.
Che il peso sia enorme ($100$) o minuscolo ($0.0001$), la L1 continua a sottrarre o sommare la stessa identica quantità fissa ad ogni ciclo di calcolo. Questa pressione costante e implacabile è ciò che permette al gradiente di colpire e azzerare istantaneamente il parametro non appena tocca lo spigolo dell’asse cartesiano.
L’Impatto sulla Fraud Detection
In un sistema antifrode reale, dove ci si trova a gestire dataset iperdimensionali con centinaia di feature (spesso sature di rumore di fondo), la scelta tra queste due filosofie sposta radicalmente il comportamento del modello in produzione:
- Se usi la L2 (Ridge): Il modello terrà in considerazione tutte le variabili disponibili. Ridurrà l’influenza e la magnitudo di quelle meno importanti per evitare che destabilizzino l’addestramento, ma manterrà l’architettura densa.
- Se usi la L1 (Lasso): Eseguirai una vera e propria epurazione ingegneristica. L’algoritmo spegnerà completamente (peso = 0) le variabili ridondanti o i segnali di disturbo, lasciandoti in mano un sottoinsieme ristretto e dominante di feature. È l’alleato ideale contro l’alta dimensionalità perché genera un modello sparso, leggero e strutturalmente ultra-veloce da calcolare in produzione, riducendo al minimo la latenza nei sistemi di scoring in tempo reale.
Nota di architettura avanzata: Algoritmi di boosting più complessi (come XGBoost o LightGBM) ereditano questo identico impianto logico L1/L2. La differenza sta nel bersaglio: anziché spostare coefficienti su un iperpiano, utilizzano queste penalità matematiche per guidare la ramificazione e la nascita dei nodi, stroncando sul nascere gli alberi decisionali troppo profondi o basati su feature puramente rumorose.
In un sistema antifrode con centinaia di feature:
- Se usi la L2, terrai in considerazione tutte le variabili, ma ridurrai l’influenza di quelle meno importanti per evitare che destabilizzino il modello.
- Se usi la L1, eseguirai una vera e propria epurazione: l’algoritmo spegnerà completamente (peso = 0) le Componenti Principali o le feature rumore, lasciandoti in mano un sottoinsieme ridotto di variabili dominanti. È l’arma definitiva contro l’alta dimensionalità, poiché genera un modello sparso, leggero e ultra-veloce da calcolare in produzione.
(Nota: algoritmi più complessi come XGBoost ereditano questo impianto logico, ma utilizzano il gradiente non per spostare coefficienti iperplanari, bensì per guidare matematicamente la ramificazione e la nascita dei nuovi alberi decisionali, penalizzando le strutture troppo profonde tramite vincoli di Regolarizzazione).
9. Il Pilastro della Spiegabilità nel Fintech
In banca non puoi rifiutare una transazione o bloccare un conto dicendo semplicemente “Me lo ha detto l’algoritmo”. Esistono normative stringenti (come il GDPR in Europa) che garantiscono al cittadino il “right to explanation”.
Questo è il motivo per cui la Regressione Logistica è tuttora imbattuta in molti sistemi di scoring: è intrinsecamente interpretabile.
I coefficienti $\beta$ estratti dal modello ci dicono esattamente l’impatto di ogni singola variabile. Elevando $e$ al coefficiente ($e^{\beta_1}$), otteniamo l’Odds Ratio.
Se la variabile $X_1$ è una componente PCA legata a transazioni estere notturne e il suo $e^{\beta_1}$ è pari a 1.45, sappiamo matematicamente che, a parità di altre condizioni, ogni aumento unitario di quella variabile aumenta del 45% le probabilità che la transazione sia una frode. Trasparente, matematico, difendibile davanti a un comitato di audit.
10. Conclusione: Dalla Probabilità alla Decisione
La Regressione Logistica fa egregiamente il suo lavoro: analizza i dati trasformati dalla PCA e ci restituisce un valore continuo tra 0 e 1 per ogni transazione.
Tuttavia, una probabilità da sola non blocca i criminali. Se il modello dice che una transazione ha il 52% di probabilità di essere una frode, cosa dobbiamo fare? Dobbiamo far passare la transazione o dobbiamo congelare la carta del cliente?
Per trasformare questa probabilità continua in una decisione aziendale netta (Sì/No), dobbiamo impostare una soglia (Classification Threshold). Ma ogni volta che spostiamo questa soglia, commettiamo degli errori diversi.
Nel prossimo articolo vedremo come costruire lo strumento di controllo definitivo per calibrare questa decisione e comprendere il costo economico dei nostri errori:
👉 [Link all’Articolo 3: Oltre l’Accuracy: Dominare la Confusion Matrix e le curve ROC nella Fraud Detection]